Aleph Alpha

Entdecken Sie Kolibri

Made in Germany. Gemacht für die Welt.

  • Leistung für geschäftskritische Anwendungen

    Entwickelt für Leistung in Anwendungsfällen mit großer Wirkung – darunter Assistenten und agentische Workflows, die mehrstufiges Reasoning, strukturierte Extraktion, Retrieval-Augmented Generation und zuverlässiges Tool Calling erfordern.

  • Souverän by design

    Vollständig von unseren Teams in Deutschland trainiert mit lückenloser Integrität der Lieferkette. Ihre Betriebsabläufe bleiben unabhängig: mit flexibler Bereitstellung, Schutz Ihres geistigen Eigentums und ohne importierten Bias.

  • Deutsch und Englisch fließend

    Spezialisiert auf Deutsch, mit eigens sorgfältig kuratierten Daten: so versteht das Modell nicht nur den Fachkontext, sondern unterstützt mehrsprachige Teams auf Deutsch und Englisch.

  • Für die Arbeit im regulierten Bereich

    Streng ausgerichtet an europäischen Rechts- und Regulierungsstandards, wie der EU-KI-Verordnung und zugehörigen Verhaltenskodizes. So ist unser Modell auch für hochsensible Arbeitsbereiche gerüstet – in der öffentlichen Verwaltung genau wie in der Industrie.

Leistung

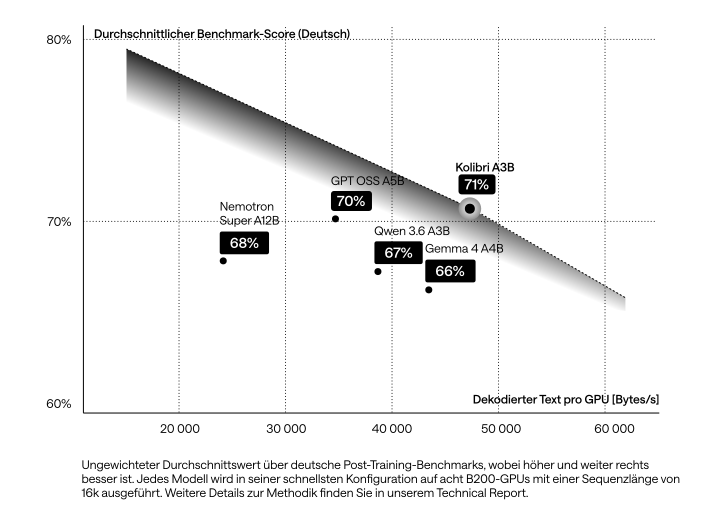
Streudiagramm: durchschnittlicher Benchmark-Score (Deutsch, %) gegen dekodierten Text pro GPU (Bytes/s). Kolibri A3B erreicht 71 % bei etwa 47.000 Bytes/s und liegt auf der Effizienzgrenze. GPT OSS A5B: 70 % bei etwa 34.500. Nemotron Super A12B: 68 % bei etwa 24.000. Qwen 3.6 A3B: 67 % bei etwa 38.500. Gemma 4 A4B: 66 % bei etwa 43.000.

Effizienz
an der Pareto-Front

Bewusst kleiner und von Grund auf effizient.

Kolibri erreicht eine mit größeren Modellen vergleichbare Leistung und erzeugt dabei mehr Text pro GPU. Das Ergebnis: Kosteneffizienz, geringerer Energieverbrauch und schnellere, besser skalierbare Deployments.

  • Nutzung von Tools und Agenten

    Was das bedeutet

    Misst, wie gut das Modell mehrstufige Dialoge führt und externe Tools und Systeme korrekt bedient, um eine Aufgabe zu erfüllen.


    Anwendungsfall

    Betrieb von Bürgerservice-Agenten, die Anliegen durchgängig bearbeiten – etwa einen Datensatz abrufen, Anspruchsvoraussetzungen prüfen oder ein Formular ausfüllen.

    Interaktives Diagramm. Pfeiltasten links und rechts wechseln den Benchmark, hoch und runter das Modell. Enter hebt ein Modell hervor, Escape hebt die Auswahl auf.

    Nutzung von Tools und Agenten
    Benchmark KolibriQwen3.6 35B-A3BMistral Small 4 119B-A6BNemotron 3 Super 120B-A12B
    Tau2-Bench (Telecom) 94.7%99.1%41.5%68.1%
    Tau2-Bench (Retail) 69.9%71.6%62.9%67.5%
    Tau2-Bench (Airline) 76.7%70.7%40%72.7%
    Tau3-Bench (Banking) 38.1%10.6%5.7%15.5%
    BFCL v4 (overall) 61.4%67.2%58%61%
  • Deutsche Sprachkompetenz

    Was das bedeutet

    Misst, wie gut das Modell in deutscher Sprache erklärt, rechnet und Anweisungen befolgt.


    Anwendungsfall

    Bürgeranfragen und amtlicher Schriftverkehr funktionieren auf Verwaltungsdeutsch mit derselben Qualität, die man auf Englisch erwartet.

    Interaktives Diagramm. Pfeiltasten links und rechts wechseln den Benchmark, hoch und runter das Modell. Enter hebt ein Modell hervor, Escape hebt die Auswahl auf.

    Deutsche Sprachkompetenz
    Benchmark KolibriQwen3.6 35B-A3BMistral Small 4 119B-A6BNemotron 3 Super 120B-A12B
    GPQA Diamond (DE) 81.3%80.6%72.9%76.6%
    Humanity's Last Exam (DE) 15.9%20.5%10.5%22.3%
    MMLU-ProX CoT (DE) 75.5%81.9%70.7%79.7%
    AIME 2025 (DE) 87.5%82.9%72.3%85.6%
    AIME 2026 (DE) 90%84.4%78.5%87.5%
  • Reasoning und analytische Aufgaben

    Was das bedeutet

    Misst die Fähigkeit des Modells, anspruchsvolle Probleme aus Mathematik und Naturwissenschaften zu lösen, die tiefes, schrittweises Denken erfordern.


    Anwendungsfall

    Unterstützt analytische Arbeit in der Verwaltung, wie etwa Planungsrechnungen und die Bewertung politischer Maßnahmen.

    Interaktives Diagramm. Pfeiltasten links und rechts wechseln den Benchmark, hoch und runter das Modell. Enter hebt ein Modell hervor, Escape hebt die Auswahl auf.

    Reasoning und analytische Aufgaben
    Benchmark KolibriQwen3.6 35B-A3BMistral Small 4 119B-A6BNemotron 3 Super 120B-A12B
    GPQA Diamond (EN) 84.3%83.4%74.7%78%
    Humanity's Last Exam (EN) 21.5%21.1%9.7%20.6%
    AA-Omniscience Index (scaled public set) 33.6%42.35%38%31.75%
    MMLU-Pro CoT (EN) 80%84.3%80.4%82.7%
    AIME 2025 (EN) 96.9%84.6%79.8%91.7%
    AIME 2026 (EN) 96%91%83.1%90.4%

Details zum Modell

Status
Öffentlich verfügbar
Architektur
Mixture-of-Experts
Parameter gesamt
78B
Aktive Parameter / Token
3B
Sprachen
Deutsch, Englisch
Kontextlänge
1.048.576 (1 Mio.) Tokens; empfohlen: 262.144 (256k) Tokens für effizienten Betrieb und komplexe Aufgaben
Genauigkeit
bfloat16
Reasoning-Modus
Ja (kontrollierbar)
Tool-Aufrufe
Ja
Hardware-Anforderungen
  • Modell-Speicherbedarf: ca. 78 GB (FP8-Gewichte)
  • Mindestanforderung: 2× A100 80 GB, 2× H100 SXM5, 1× H200, 1× B200 oder 1× B300
  • Empfohlen: 2× H100 SXM5, 2× H200, 1× B200 oder 1× B300
Wissensstand
EN: 18. Jun. 2026, DE: 18. Jun. 2026
Am besten geeignet für
  • Mehrstufiges Reasoning
  • Retrieval-Augmented Generation
  • Agentische Tool-Aufrufe
  • KI-Assistent in Deutsch und Englisch
Lizenz
Apache 2.0
Sufficiently Detailed Summary
Zur Zusammenfassung
Modellkarte
Zur Modellkarte

Verwenden Sie unser Modell

Laden Sie die offenen Modellgewichte über Hugging Face herunter. Oder kontaktieren Sie unser Vertriebsteam, das Sie bei den Themen Unternehmensbereitstellung und Spezialisierung unterstützt.

Erfahren Sie mehr

Mehr Informationen zur Leistung unseres Modells und den verschiedenen Fähigkeiten. Lernen Sie mehr über unsere Datenkuratierung, Modellarchitektur und unseren Trainingsansatz.